ACT 학습 (Hub 데이터셋 다운로드 & Training)
데이터 기록에서 기록하고 데이터셋 편집에서 정리해 Hub에 올린 데이터셋으로, 이제 정책(policy)을 학습시킵니다. 정책은 카메라 영상과 관절 상태를 입력받아 다음 행동을 내놓는 신경망이며, 학습이 끝나면 사람이 리더 암을 잡지 않아도 로봇이 스스로 작업을 수행합니다.
이 페이지는 로봇을 조작하던 PC가 아닌 별도의 GPU PC에서 학습한다는 것을 전제로 합니다. 데이터는 실행용 PC에서 기록해 Hub에 올렸고, 훈련용 PC는 그것을 Hub에서 내려받아 학습한 뒤 결과 모델을 다시 Hub에 올립니다. 실행용 PC는 그 모델을 받아 ACT 추론에서 로봇을 움직입니다. Hub가 두 PC 사이의 전달 통로입니다.
| 단계 | 어디서 | 무엇을 |
|---|---|---|
| 데이터 기록, 데이터셋 편집 | 실행용 PC | 데이터셋 기록, 편집, Hub 업로드 |
| ACT 학습 (이 페이지) | 훈련용 GPU PC | 데이터셋 다운로드, ACT 학습, 모델 Hub 업로드 |
| ACT 추론 | 실행용 PC | 모델 다운로드, LeKiwi에서 모델 추론 |
이 페이지에서는 LeRobot이 기본으로 제공하는 정책 중 가장 먼저 추천되는 ACT를 학습시킵니다.
학습 목표
- ACT가 어떤 입력을 받아 어떤 출력을 내는지, LeKiwi 데이터셋과 어떻게 대응되는지 설명할 수 있다.
- 훈련용 GPU PC에서 Hub의 데이터셋을 내려받아 학습을 실행하고, 중단된 학습을 재개할 수 있다.
- 학습된 모델을 Hub에 올리고 실행용 PC에서 받는 흐름을 이해한다.
1. ACT (Action Chunking with Transformers)
ACT는 Zhao 등이 논문 Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware[1]에서 소개한 모방 학습 정책입니다. 저렴한 하드웨어와 적은 시연 데이터로 정밀한 조작을 수행하도록 설계되어, LeRobot을 처음 시작할 때 가장 먼저 추천되는 모델입니다.
1.1. 처음 시작하기에 적합한 이유
- 빠른 학습. GPU 한 장으로 몇 시간 안에 학습됩니다.
- 가벼운 크기. 매개변수가 약 8천만 개로, 실행용 PC의 GPU 없이도 추론이 가능한 수준입니다.
- 데이터 효율. 시연 50회 정도로도 높은 성공률에 도달하는 경우가 많습니다.
1.2. 구조
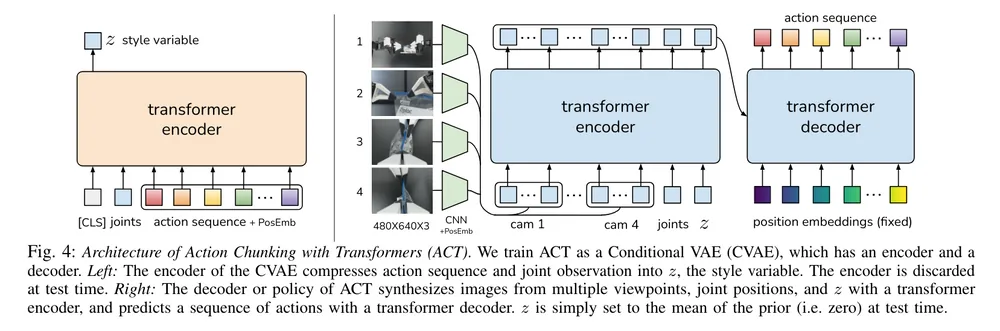
ACT는 트랜스포머 기반이며 세 부분으로 이루어집니다[1].
- 비전 백본. ResNet-18이 각 카메라 이미지를 특징 벡터로 바꿉니다.
- 트랜스포머 인코더. 카메라 특징, 관절 상태, 학습된 잠재 변수를 종합합니다.
- 트랜스포머 디코더. cross-attention으로 앞으로 수행할 행동 시퀀스를 한 번에 생성합니다.
Action Chunking은 행동을 한 스텝씩이 아니라 여러 스텝 묶음(chunk)으로 예측한다는 뜻입니다. 기본 설정은 100스텝, 즉 30 FPS 데이터셋에서 약 3초 분량의 행동을 한 번에 내놓습니다. 매 스텝 판단하는 방식보다 동작이 부드럽고 일관됩니다.
1.3. LeKiwi 데이터셋과의 대응
ACT는 데이터셋의 특성 이름을 그대로 입력과 출력으로 삼습니다. 데이터 기록에서 기록한 LeKiwi 데이터셋은 다음과 같이 대응됩니다.
| 구분 | 데이터셋 특성 | 내용 |
|---|---|---|
| 입력 (시각) | observation.images.front, observation.images.wrist | 텔레오퍼레이션 호스트 명령의 카메라 이름 그대로 |
| 입력 (상태) | observation.state | 팔 관절 6개 위치 + 바퀴 3개 속도 = 9차원 |
| 출력 | action | 같은 9차원. 팔 목표 위치와 바퀴 목표 속도 |
SO-ARM 단독 데이터셋은 6차원이지만 LeKiwi는 이동 베이스가 포함되어 9차원입니다. LeRobot이 데이터셋 메타데이터에서 자동으로 읽으므로 별도 설정은 없지만, ACT 추론에서 추론할 때 이 9차원을 유지하는 코드를 써야 하는 이유가 됩니다.
2. [훈련용 PC] 데이터셋 내려받기
여기서부터는 LeRobot 설치(Ubuntu · Windows)에서 lerobot[training] 을 설치하고 GPU 인식을 확인한 훈련용 PC에서 진행합니다. 실행용 PC에서 하던 터미널을 그대로 쓰는 것이 아니라, 훈련용 PC에 접속해 conda 환경을 활성화한 새 터미널입니다. 훈련용 PC의 명령은 Ubuntu 터미널(bash) 기준입니다.
conda activate lerobot0602.1. Hub 로그인
훈련용 PC는 아직 Hub에 로그인되어 있지 않습니다. 데이터셋을 받고 학습 결과를 올리기 위해 데이터 기록과 같은 계정으로 로그인합니다. 토큰은 데이터 기록에서 만든 것을 그대로 쓰면 됩니다.
hf auth login --token <hf_복사한토큰>
hf auth whoami
2.2. 환경 변수
데이터 기록부터 써 온 이름을 그대로 씁니다. 데이터셋 편집에서 에피소드를 삭제한 데이터셋으로 학습하려면 TASK_NAME 뒤에 _after_delete 처럼 편집 결과 이름을 붙입니다.
export HF_USER="HueyWoo"
export TASK_NAME="lekiwi_pick_and_place"
export TASK_DESCRIPTION="Pick up the cube and place it in the box"
TASK_DESCRIPTION 은 데이터 기록 기록 명령의 --dataset.single_task 와 같은 문장으로 둡니다. ACT는 언어 입력을 쓰지 않아 학습에는 쓰이지 않지만, ACT 추론에서 추론 스크립트의 --task 로 이 문장을 넘깁니다.
2.3. 데이터셋 내려받기
훈련용 PC에는 데이터셋이 없으므로 Hub에서 받아 옵니다. 데이터 기록 마지막에 --dataset.push_to_hub=true 로 올렸거나 데이터셋 편집에서 업로드한 이름입니다.
hf download ${HF_USER}/${TASK_NAME} --repo-type dataset \
   --local-dir ~/.cache/huggingface/lerobot/${HF_USER}/${TASK_NAME}
받은 데이터셋은 실행용 PC와 같은 위치인 ~/.cache/huggingface/lerobot/ 아래에 놓입니다. 다음 명령으로 에피소드 수와 특성이 실행용 PC에서 본 것과 같은지 확인합니다.
lerobot-edit-dataset \
    --repo_id=${HF_USER}/${TASK_NAME} \
    --operation.type=info \
--operation.show_features=trueobservation.images.front, observation.images.wrist, 9차원 observation.state 와 action 이 보이면 정상입니다.
팁
lerobot-train은--dataset.repo_id의 데이터셋이 로컬에 없으면 Hub에서 자동으로 받으므로 이 단계를 건너뛰어도 학습은 됩니다. 다만 수 GB를 받는 동안 학습 명령이 멈춘 것처럼 보이고, 잘못된 이름을 넣었을 때 오류를 늦게 알게 되므로 미리 받아 두는 것을 권합니다.
3. [훈련용 PC] 학습
3.1. 학습 실행
lerobot-train \
  --dataset.repo_id=${HF_USER}/${TASK_NAME} \
  --policy.type=act \
  --policy.repo_id=${HF_USER}/${TASK_NAME}_act \
  --policy.device=cuda \
  --job_name=${TASK_NAME} \
  --output_dir=outputs/train/act_lekiwi/${TASK_NAME} \
  --steps=50_000 \
  --save_checkpoint=true \
  --save_freq=10_000 \
  --batch_size=8 \
  --num_workers=8 \
  --wandb.enable=false \
--policy.push_to_hub=true| 옵션 | 의미 |
|---|---|
--dataset.repo_id | 학습 데이터셋. 로컬에 없으면 Hub에서 받음 |
--policy.type=act | 정책 종류 |
--policy.repo_id | 학습이 끝난 모델을 올릴 Hub 이름. 데이터셋 이름 뒤에 _act 를 붙여 무엇으로 학습한 모델인지 드러냅니다 |
--policy.device=cuda | GPU 사용. LeRobot 설치에서 GPU 인식을 확인한 상태여야 합니다 |
--output_dir | 체크포인트가 저장될 로컬 폴더 |
--steps | 총 학습 스텝. 에피소드 10~20개 규모에서는 5만 스텝이 적당한 출발점 |
--save_freq | 체크포인트 저장 간격. 1만 스텝마다 저장하면 중간 모델을 비교할 수 있습니다 |
--batch_size | 한 번에 학습하는 샘플 수. GPU 메모리가 부족하면 4로 줄입니다 |
--num_workers | 데이터 로딩 프로세스 수. CPU 코어 수에 맞춥니다 |
--wandb.enable | 학습 곡선을 Weights & Biases에 기록할지 여부 |
경고
--policy.repo_id는 생략하면 안 됩니다. LeRobot은 학습이 끝나면 모델을 Hub에 올리는 것이 기본 동작이라, 이 값이 없으면 시작 단계에서'repo_id' argument missing오류로 멈춥니다. Hub에 올리지 않으려면--policy.push_to_hub=false를 추가합니다.
wandb를 켜려면
wandb login으로 먼저 로그인한 뒤--wandb.enable=true로 바꿉니다. 손실 곡선을 브라우저에서 볼 수 있어 학습이 잘 되는지 판단하기 쉽습니다. 켜지 않아도 터미널에 200스텝마다 손실이 출력됩니다.
3.2. 학습 중 확인할 것
터미널에 주기적으로 loss 값이 출력됩니다. 초반에 빠르게 떨어지다가 서서히 낮아지면 정상입니다. 체크포인트는 다음 위치에 쌓입니다.
outputs/train/act_lekiwi/<TASK_NAME>/checkpoints/
├── 010000/pretrained_model/
├── 020000/pretrained_model/
├── ...
└── last -> 가장 최근 체크포인트
각 pretrained_model 폴더가 그 시점의 완전한 모델이라, ACT 추론에서 어느 체크포인트로든 추론해 볼 수 있습니다. 스텝 수가 많다고 늘 좋은 것은 아니며, 데이터가 적을 때는 후반 체크포인트가 과적합되는 경우도 있습니다.
3.3. 학습 재개
학습이 중단되었을 때 마지막 체크포인트부터 이어서 진행합니다. 설정 파일을 지정하고 --resume=true 를 붙입니다.
lerobot-train \
  --config_path=outputs/train/act_lekiwi/${TASK_NAME}/checkpoints/last/pretrained_model/train_config.json \
  --resume=true \
--steps=50_000--steps는 추가 스텝이 아니라 총 스텝입니다. 3만 스텝에서 멈췄고 5만까지 채우려면 그대로50_000을 주고, 더 학습시키고 싶으면80_000처럼 늘립니다.
4. 학습된 모델 올리기와 받기
4.1. Hub 업로드
학습이 정상 종료되면 --policy.repo_id 에 지정한 이름으로 모델이 자동 업로드됩니다. 브라우저에서 확인할 수 있습니다.
https://huggingface.co/<HF_USER>/<TASK_NAME>_act업로드 없이 학습을 끝냈거나 특정 체크포인트를 올리고 싶다면 체크포인트의 pretrained_model 폴더를 통째로 올립니다. 이 폴더에는 모델 가중치와 함께 추론에 필요한 전처리·후처리 파일(policy_preprocessor*, policy_postprocessor*, 정규화 통계 포함)이 들어 있어, 하나라도 빠지면 실행용 PC에서 모델을 불러오지 못합니다.
hf upload ${HF_USER}/${TASK_NAME}_act outputs/train/act_lekiwi/${TASK_NAME}/checkpoints/last/pretrained_modellast 대신 030000 처럼 스텝 번호를 넣으면 그 체크포인트가 올라갑니다.
4.2. [실행용 PC] 모델 내려받기
로봇을 움직이는 실행용 PC는 훈련용 PC와 다른 컴퓨터인 경우가 많습니다. ACT 추론의 추론 스크립트는 --policy.path 에 Hub 이름을 주면 자동으로 받으므로 별도 작업이 없습니다. 미리 받아 두려면 다음 명령을 씁니다.
hf download ${HF_USER}/${TASK_NAME}_acthf download %HF_USER%/%TASK_NAME%_act훈련용 PC와 실행용 PC가 같은 컴퓨터라면 Hub를 거치지 않고 체크포인트 경로를 그대로 쓰면 됩니다.
outputs/train/act_lekiwi/<TASK_NAME>/checkpoints/last/pretrained_model5. 문제 해결
| 증상 | 확인할 것 |
|---|---|
'repo_id' argument missing | --policy.repo_id 누락, 또는 --policy.push_to_hub=false 추가 |
CUDA out of memory | --batch_size=4 로 줄이기. 그래도 부족하면 --num_workers 도 줄임 |
torch.cuda.is_available() 가 False | LeRobot 설치의 PyTorch GPU 인식 확인 절 다시 진행 |
| 데이터셋을 찾지 못함 | hf auth whoami 로 로그인 확인. 데이터셋 편집에서 편집한 이름을 쓰는지 확인 |
| 학습은 되는데 매우 느림 | --policy.device=cuda 인지, wandb 온라인 모드로 네트워크 대기가 있는지 확인 |
| 업로드 시 인증 오류 | 토큰 권한이 Write인지 확인 |
6. 정리
- ACT는 카메라 영상과 관절 상태를 받아 여러 스텝의 행동 묶음을 한 번에 예측하는 트랜스포머 정책입니다.
- LeKiwi 데이터셋은 팔 6차원과 베이스 3차원을 합친 9차원 상태와 행동을 가집니다.
- 학습은 훈련용 PC에서
lerobot-train으로 하며, 데이터셋 이름과 모델 이름은 데이터 기록부터의 규칙(<TASK_NAME>,<TASK_NAME>_act)을 그대로 따릅니다. - 학습이 끝나면 모델이 Hub에 자동 업로드되고, 실행용 PC에서는 그 이름으로 바로 받아 씁니다.
ACT 추론에서 이 모델을 LeKiwi에서 실행해 로봇이 스스로 작업하는 모습을 확인합니다.
각주
[1] ZHAO, Tony Z., et al. Learning fine-grained bimanual manipulation with low-cost hardware. arXiv preprint arXiv:2304.13705, 2023.